五種場景的實際表現
| 場景 | 可用度 | 主要問題 |
|---|---|---|
| 單人口述、安靜環境 | 高 | 幾乎可直接用,偶有標點問題 |
| Podcast 雙人對談 | 中高 | 換人說話的切分偶爾錯 |
| 會議多人討論 | 中 | 重疊說話會漏,需人工校對 |
| 含大量英文術語 | 中 | 中英夾雜處最容易出錯 |
| 現場收音有雜訊 | 低到中 | 建議先降噪再轉 |
整體而言,單人安靜環境的結果通常可以直接用,多人會議則一定要人工校對一輪。
四個固定弱點
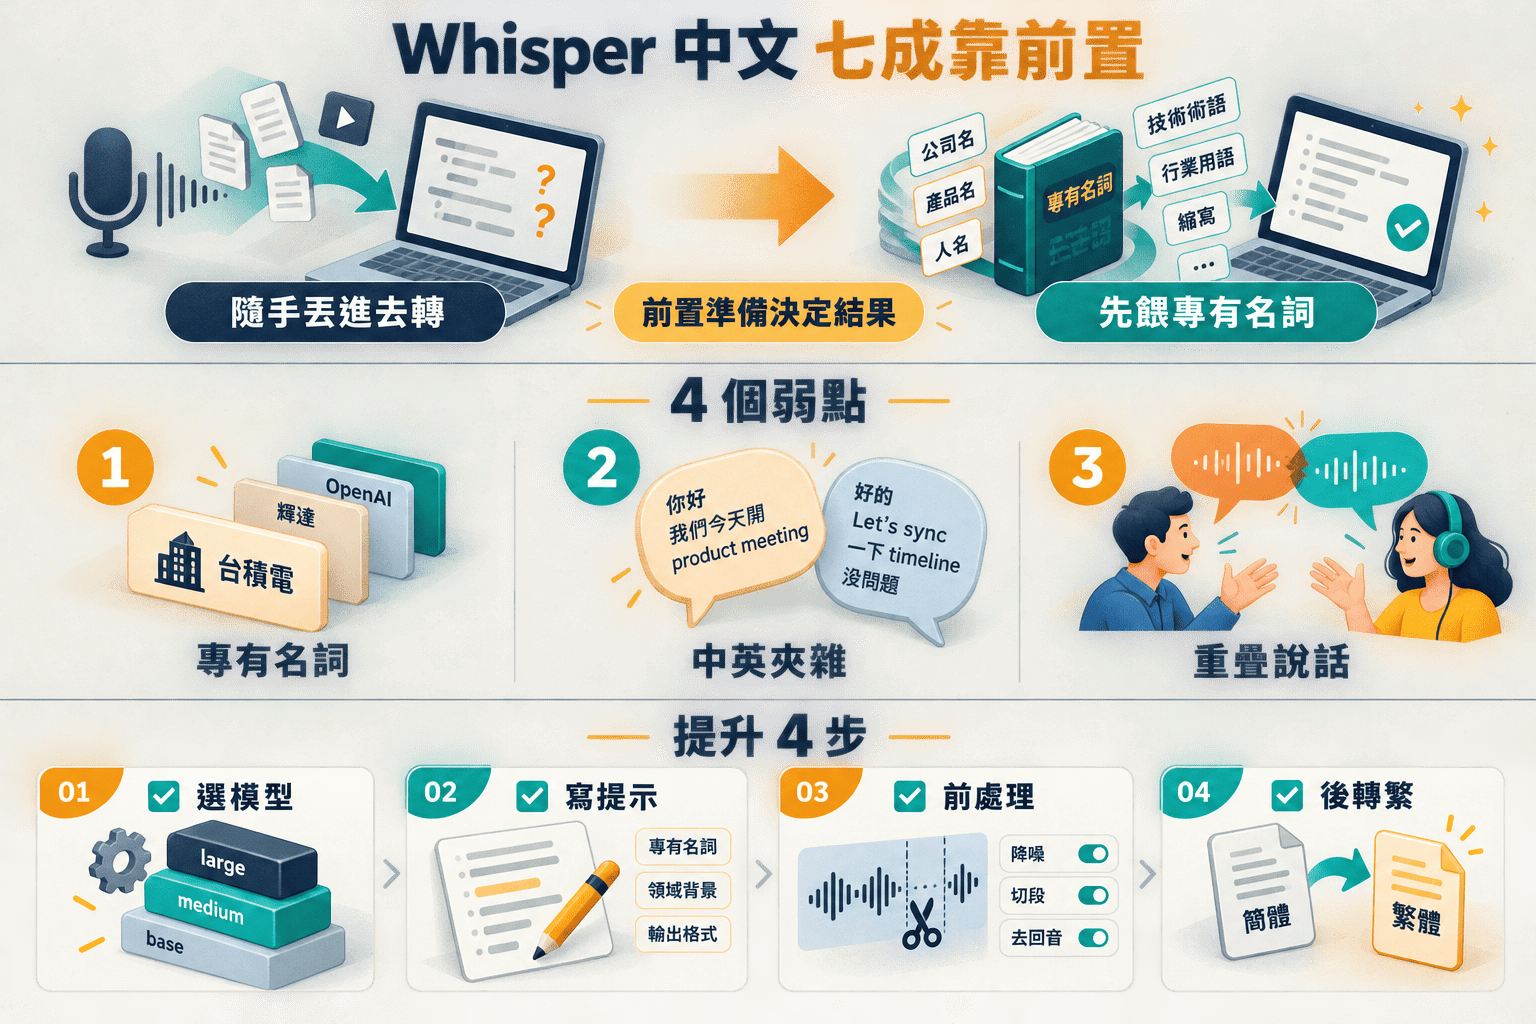
- 專有名詞:品牌名、人名、產品名會被轉成同音字,這是最常見的錯誤
- 中英夾雜:「這個 campaign 的 ROAS」這種句子,英文部分可能被音譯成中文
- 簡繁混雜:模型傾向輸出簡體,繁中使用者一定要做後處理
- 重疊說話:兩人同時講話時會漏掉其中一方,這是架構限制不是調參能解決的
三個提升技巧
一、用 initial_prompt 餵專有名詞
這是投報率最高的單一技巧。在轉錄前給模型一段提示,列出會出現的專有名詞與偏好的書寫風格。
實務作法:把公司名、產品名、常用術語、以及與會者姓名寫成一段話當 prompt。模型會傾向用這些詞彙,專有名詞的錯誤率能明顯下降。
順便也能用這段 prompt 引導輸出繁體(在提示裡使用繁體書寫)。
二、先處理音檔再轉錄
- 降噪:背景雜訊明顯時先過一次降噪
- 音量正規化:多人音量落差大時,小聲的人容易被漏掉
- 分軌:重要會議建議每人一軌分開錄,分別轉錄再合併時間軸
分軌是解決重疊說話的唯一有效方法,調參數沒有用。
三、選對模型大小
| 模型 | 速度 | 準確度 | 適合 |
|---|---|---|---|
| small | 快 | 中 | 草稿、內部快速參考 |
| medium | 中 | 中高 | 會議紀錄加人工校對 |
| large 系列 | 慢 | 高 | 要公開發布的內容 |
判斷原則:要給別人看的用 large,自己參考的用 medium。差別主要在專有名詞與語句完整度。
後處理流程
- 簡繁轉換:這一步幾乎一定要做
- 專有名詞取代:建一份常錯對照表,批次取代
- 段落切分:原始輸出常是長段落,依語意切分
- 標點修正:中文標點的判斷常有誤
- 人工校對:重要內容一定要有這一步
把前四步寫成腳本,每次轉完自動跑,可以省下大量時間。
【使用 5 問】
- 這份逐字稿要給誰看?決定要用哪個模型
- 有多少專有名詞?多的話一定要用 initial_prompt
- 會不會有人同時說話?會的話考慮分軌錄音
- 你做簡繁轉換了嗎?模型預設傾向簡體
- 有建常錯對照表嗎?同樣的錯會重複出現
【決策樹】這份音檔怎麼處理
Q1:用途?
├─ 內部參考、搜尋用 → medium 加自動後處理即可
├─ 要公開發布 → large 加人工校對
└─ 要做字幕 → large,而且要處理時間軸

Q2:錄音品質?
├─ 單人安靜 → 直接轉
├─ 多人但分軌 → 分別轉再合併
├─ 多人同一軌 → 先降噪,預期要大量校對
└─ 雜訊嚴重 → 先降噪,必要時重錄

Q3:專有名詞多嗎?
├─ 多 → 一定要寫 initial_prompt
└─ 少 → 直接轉,後處理修即可
【常見 3 錯誤】
- 錯誤 1:不用 initial_prompt。這是成本最低效果最明顯的一步,跳過很可惜
- 錯誤 2:忘記簡繁轉換。輸出夾雜簡體字直接拿去用,很容易被看出來
- 錯誤 3:期待多人會議免校對。重疊說話是架構限制,不要以為換模型或調參數能解決
【檢核】轉錄前打勾表
- ☐ 已依用途選定模型大小
- ☐ 已寫好含專有名詞的 initial_prompt
- ☐ 音檔已降噪或正規化(必要時)
- ☐ 後處理含簡繁轉換與常錯取代
- ☐ 重要內容已安排人工校對
結論:七成的改善來自前置準備
多數人對 Whisper 中文表現不滿意,原因不是模型不行,是少做了前置準備。寫一段 initial_prompt 把專有名詞餵進去、錄音時盡量分軌、轉完自動跑簡繁轉換與常錯取代,這三件做了之後,結果會跟隨手轉一份差很多。至於多人重疊說話,那是架構限制,解法在錄音端而不是轉錄端。